Спросите ChatGPT дважды «какой интернет-магазин часов выбрать в Москве». Вы получите два разных списка: порядок, набор брендов и даже длина текста отличаются. Каждый такой запрос и есть прогон: один запрос одного промпта к одной нейросети и один полученный текст. Ответы случайны, поэтому каждый промпт задают несколько раз, а видимость считают по всем ответам.
Зачем повторять
Модель выбирает следующее слово с долей случайности (подробнее в статье про температуру генерации), а поисковые модели ещё и подтягивают разные страницы. Один ответ показывает, что могло случиться, но не то, как бывает обычно. Об этом подробнее в статье про разброс ответов. Видимость бренда поэтому считается как доля ответов, где он назван, и чем больше прогонов, тем меньше она зависит от удачи.
Сколько прогонов в LLMetr
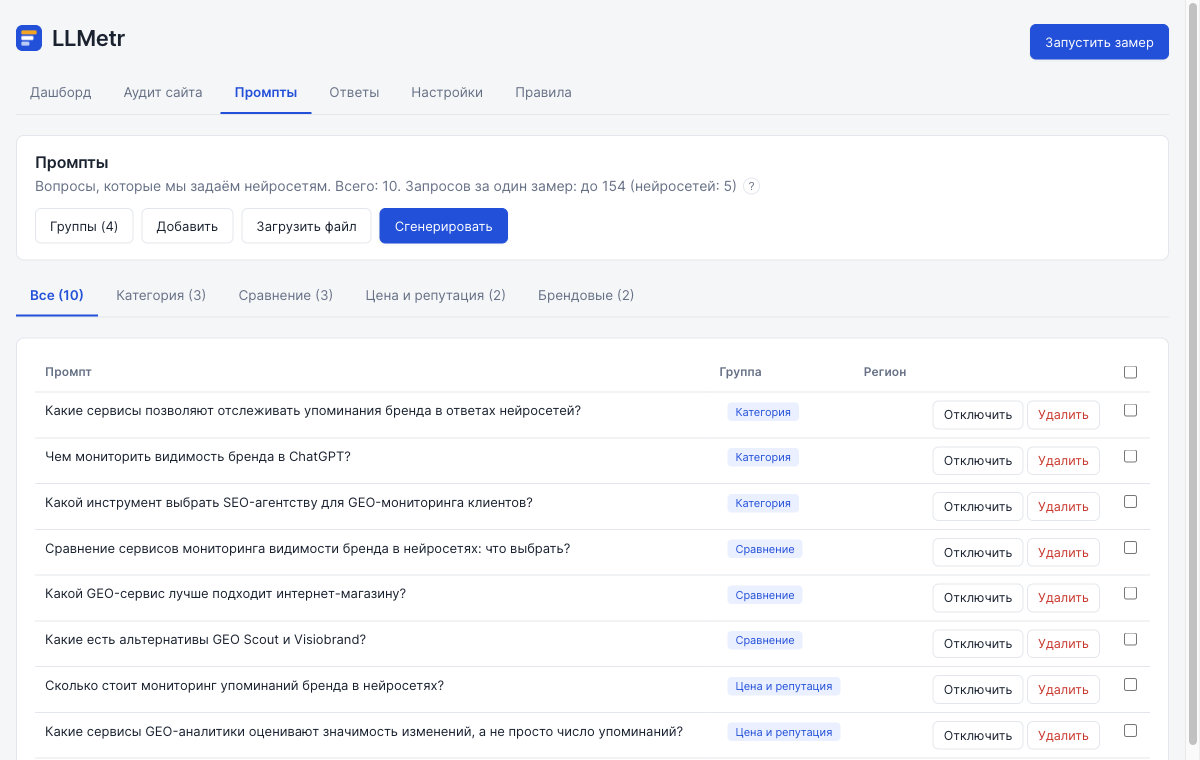
Настраивать число прогонов не нужно: мы подобрали его под каждую нейросеть на больших объёмах данных и держим в общих настройках сервиса. Обычно это два-три прогона на вопрос, и повторы входят в проверку, лимит они не тратят. Вопросы с названием вашего бренда («{brand} отзывы», «адрес») отвечают стабильно, для них хватает одного прогона. Достаточно отметить их как «с брендом» в окне «Группы».
Это адаптивные повторы. Если оба пробных ответа назвали бренд или оба не назвали, ещё три запроса мало что добавят, и LLMetr их не снимает. Спорные промпты добираются полностью. Экономия идёт на устойчивых ячейках, а точность остаётся там, где она нужна.
Условный пример. В проекте 20 небрендовых промптов, 3 прогона, одна нейросеть: запланировано 60 ответов. Бренд назван в 21, видимость 21 / 60 = 35%. Если при адаптивных повторах 12 промптов сошлись на первых двух прогонах (8 «нет», 4 «да»), для них сделано по 2 ответа вместо 3. Всего 12 × 2 + 8 × 3 = 48 ответов, расход меньше на пятую часть.
Что путают
Судят по одному ответу. Один прогон годится для быстрой проверки, но не для вывода «нас перестали называть». Требуют «побольше прогонов» на всё, хотя у устойчивых промптов результат от этого не меняется, а нестабильные мы и так добираем. Сравнивают замеры с разным числом прогонов, не глядя на размер выборки, лучше смотреть на значимость. И принимают прогон за замер: замер включает все прогоны всех промптов по всем выбранным нейросетям.
Следите за индикатором полноты: недособранные ответы (ошибка провайдера, отказ модели) исключаются из статистики, а LLMetr делает второй проход. Сравнивая замеры, смотрите на значимость и число пар, а не только на разницу в процентах.
Обновлено 22.10.2026. Нашли неточность? Напишите через форму обратной связи.